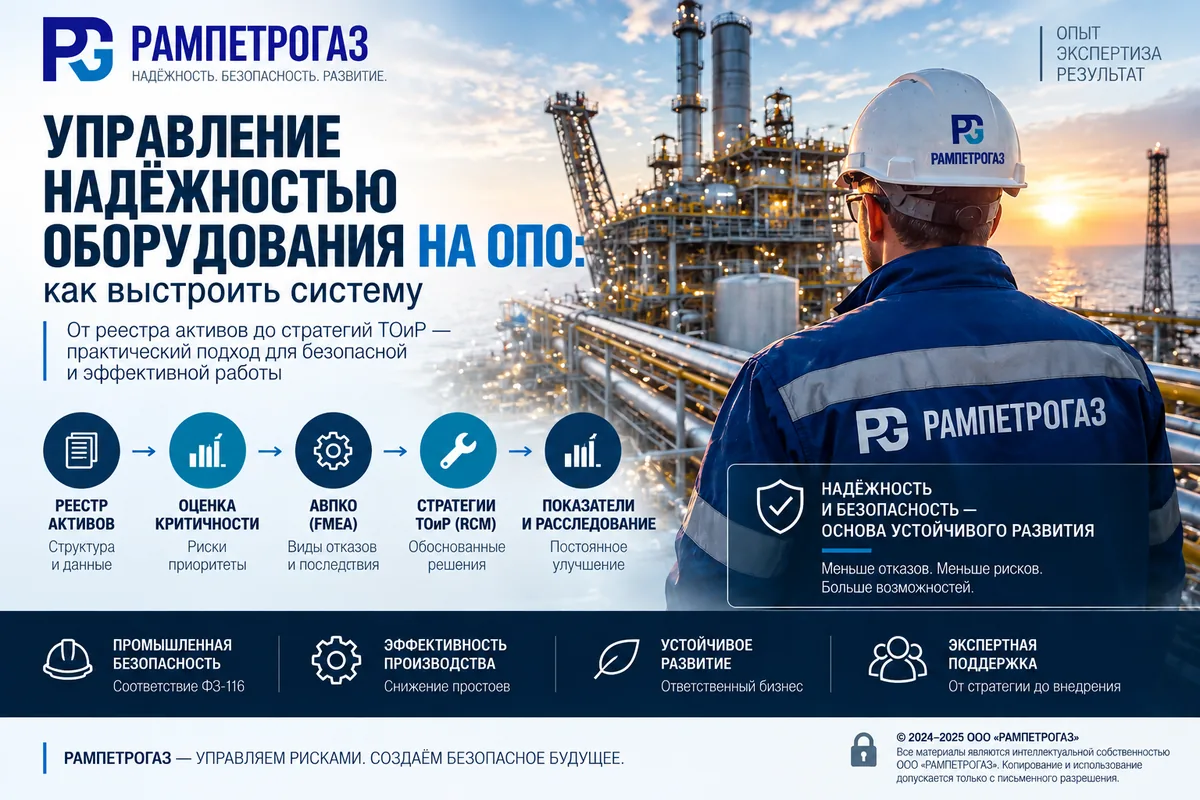
Управление надёжностью оборудования на опасном производственном объекте — это замкнутый процесс, в котором вид, объём и периодичность технического обслуживания определяются последствиями и вероятностью отказа конкретной позиции, а не единым календарным графиком. Система опирается на четыре обязательных элемента: реестр и иерархию активов, оценку критичности оборудования, анализ видов и последствий отказов и стратегии обслуживания. Замыкают её показатели надёжности и расследование отказов — без обратной связи стратегии перестают соответствовать фактическому состоянию оборудования уже через один-два ремонтных цикла. Ниже разобрано, как это устроено применительно к российским ОПО и где внедрение останавливается чаще всего.
Почему на ОПО надёжность и промышленную безопасность нельзя разделять
На объектах, поднадзорных Ростехнадзору, отказ оборудования имеет два измерения. Производственное — недовыпуск продукции, аварийный ремонт, влияние на смежные установки. И регуляторное — инцидент или авария влекут расследование, предписания, внеочередную экспертизу и возможную приостановку эксплуатации.
Федеральный закон № 116-ФЗ «О промышленной безопасности опасных производственных объектов» делит ОПО на четыре класса опасности. От класса зависят режим федерального надзора, обязанность создавать систему управления промышленной безопасностью и необходимость разрабатывать декларацию промышленной безопасности; производственный контроль при этом обязателен для объектов всех классов. Параллельно действуют федеральные нормы и правила по видам оборудования: например, ФНП № 536 для оборудования, работающего под избыточным давлением, задающие обязательные сроки технического освидетельствования и экспертизы промышленной безопасности.
Отсюда особенность, которой нет на обычном производстве: часть работ выполняется потому, что этого требует норма, а не потому, что этого требует состояние оборудования. Задача системы надёжности — не подменить обязательные процедуры, а надстроить над ними слой обоснованных решений: где обязательного объёма недостаточно и где сверх него выполняются работы, не дающие вклада в безотказность.
Почему отдельные работы не складываются в надёжность
Обслуживание по единому графику удобно администрировать: понятен бюджет, понятны трудозатраты, легко отчитаться. Но такой график не различает позиции по последствиям отказа. Результат предсказуем, часть оборудования обслуживается избыточно, часть критичного недополучает внимания, а общий объём работ растёт быстрее, чем безотказность.
Надёжность возникает не из количества ремонтов, а из их обоснованности. Ключевой вопрос смещается с «что мы обслуживаем» на «какой отказ мы предотвращаем и какова цена, если он произойдёт».
Система держится на трёх опорах: корректно назначенных стратегиях обслуживания, качестве данных об оборудовании и дисциплине работы с отказами. Проседание любой из трёх обесценивает остальные. Чаще всего проседает вторая, и об этом отдельно ниже.
Четыре уровня системы и их нормативная опора
Уровни выстраиваются строго последовательно: каждый следующий использует результат предыдущего как вход. Попытка перескочить через уровень — самая частая причина того, что внедрение не даёт эффекта.
Именно такая последовательность исключает главную ошибку — назначение работ по привычке, без связи с фактическим риском. Комплексное управление надёжностью оборудования объединяет эти уровни в единый процесс, а не применяет методики разрозненно: результат оценки критичности задаёт объём FMEA, результат FMEA — содержание стратегий, стратегии — состав планов технического обслуживания и наряд-заказов.
| Уровень системы | Что даёт | Нормативная и методическая опора |
|---|---|---|
| Реестр и иерархия активов | Структурированный перечень оборудования с привязкой к функциональным позициям. Основа планирования, статистики и бюджетирования | ГОСТ Р 70841-2023 (ИСО 14224:2016) — таксономия оборудования и отказов; ГОСТ Р 55.0.02-2014 (ИСО 55001) |
| Оценка критичности | Приоритизация: где отказ дороже и опаснее. Задаёт глубину последующего анализа и объём работ | Корпоративная матрица риска, ГОСТ Р ИСО 31000-2019 |
| Анализ видов и последствий отказов (АВПКО / FMEA) | Перечень видов отказов, их причин и механизмов повреждения по критичным позициям | ГОСТ 27.310-95 (АВПКО), ГОСТ Р 27.303-2021 (МЭК 60812:2018) |
| Стратегии обслуживания (RCM) | Обоснованный вид, объём и периодичность работ под каждый значимый вид отказа | ГОСТ Р 27.606-2013 (МЭК 60300-3-11:2009) |
| Показатели и расследование отказов | Замыкающий контур обратной связи: подтверждает эффект и удерживает систему от деградации | ГОСТ Р 70841-2023, внутренние регламенты расследования отказов |
Данные об отказах — узкое место, о котором говорят реже всего
RCM и оценка критичности работают на статистике отказов. На большинстве российских ОПО эта статистика формально существует — в оперативных журналах, актах расследования, заявках ремонтной службы. Но для анализа она непригодна: один и тот же отказ описан разными словами, причина и проявление перепутаны, оборудование не привязано к функциональной позиции, а повторяющиеся события не связаны между собой.
Эту задачу решает ГОСТ Р 70841-2023 (ИСО 14224:2016), введённый в действие в сентябре 2023 года взамен применения международного стандарта напрямую. Он задаёт таксономию оборудования нефтяной и газовой промышленности, единый перечень видов и причин отказов и правила их описания, от уровня установки до сменной единицы. Пока отказы не кодируются по единой схеме, любой расчёт средней наработки на отказ и любое обоснование периодичности опираются на экспертное суждение, а не на данные предприятия.
Практический вывод, который экономит год работы: внедрять таксономию отказов нужно одновременно с реестром активов, а не после того, как «накопится статистика». Статистика без структуры не накапливается, а накапливается текст.
Критичные элементы безопасности: где надёжность смыкается с ПБ
Отдельный класс оборудования на ОПО — критичные элементы безопасности (КЭБ, в международной практике SCE): системы противоаварийной защиты, предохранительные устройства, газоанализ, аварийное отключение, пожаротушение. Их отказ не останавливает производство напрямую, но снимает барьер между отклонением и аварией — и потому не проявляется в обычной статистике простоев.
К таким элементам применяется отдельная логика. Их выявляют в ходе HAZOP и анализа слоёв защиты (LOPA), для контуров противоаварийной защиты определяется требуемый уровень полноты безопасности (SIL) по ГОСТ Р МЭК 61511, а периодичность проверочных испытаний задаётся расчётом, а не общим регламентом.
Верификация SIL — самостоятельная инженерная задача. Рассчитывается средняя вероятность отказа на запрос (PFDavg) исходя из интенсивности опасных необнаруживаемых отказов, архитектуры контура, коэффициента отказов по общей причине, полноты и интервала проверочных испытаний. Отдельно проверяются архитектурные ограничения — отказоустойчивость аппаратной части и доля безопасных отказов (SFF). Практический смысл в том, что интервал проверочных испытаний оказывается не административным решением, а параметром, от которого напрямую зависит достигнутый уровень SIL. Если система управления надёжностью не различает КЭБ и обычное оборудование, она рано или поздно «оптимизирует» именно тот интервал, который трогать нельзя.
Статическое оборудование: RBI(ИУФР) и механизмы повреждения
Для сосудов под давлением, технологических трубопроводов и резервуаров работает отдельная ветвь системы: инспекция с учётом фактора риска (RBI) по API 580/581. Метод, объём и периодичность контроля определяются сочетанием вероятности отказа и последствий (PoF × CoF), причём вероятность отказа рассчитывается через активные механизмы повреждения, а не через календарный срок службы.
Перечень механизмов задаёт API RP 571: общая и локальная коррозия, коррозионное растрескивание под напряжением, водородное расслоение, высокотемпературная водородная коррозия, ползучесть, термическая усталость, охрупчивание и другие. Определить, какие из них активны на конкретной позиции, можно только зная рабочую среду, температурный режим, марку стали и историю эксплуатации. Это самая ресурсоёмкая часть RBI и одновременно та, где ошибка обходится дороже всего: неверно исключённый механизм повреждения означает, что позиция годами контролируется не тем методом.
Результат RBI превращается в программу инспекций, которая исполняется по API 510 для сосудов под давлением, API 570 для технологических трубопроводов и API 653 для надземных резервуаров хранения. В российском контуре эта программа не заменяет обязательные процедуры — техническое освидетельствование и экспертизу промышленной безопасности, — а надстраивается над ними: показывает, где сверх обязательного объёма нужен дополнительный контроль и какой именно, а где обязательного достаточно и наращивать нечего.
Где внедрение останавливается чаще всего
- Начинают с закупки платформы или системы мониторинга, не имея реестра и оценки критичности. Инструмент получает на вход неструктурированные данные и воспроизводит существующий беспорядок быстрее и нагляднее.
- Проводят FMEA по всему парку оборудования сразу. Ресурс уходит на позиции, отказ которых не имеет значимых последствий, а анализ действительно критичных узлов делается формально.
- Разрабатывают стратегии и не меняют планы ТО. Результат анализа остаётся отчётом, а наряд-заказы продолжают формироваться по прежним нормативам.
- Не назначают владельца процесса. Надёжность становится общей задачей ремонтной службы, технолога и службы промышленной безопасности — то есть ничьей.
- Считают эффект только по экономии на ТОиР. Основная часть эффекта обычно лежит в недопущенных простоях, а не в сокращении объёма работ.
Когда система перестаёт помещаться в таблицы
До нескольких сотен единиц оборудования систему можно вести в электронных таблицах. Начиная примерно с тысячи функциональных позиций(Functional location) табличная модель перестаёт работать по трём причинам. Теряется связность: изменение критичности позиции не транслируется в стратегию и план обслуживания. Теряется история решений: непонятно, почему периодичность именно такая и кто это обосновал. И отсутствует аудиторский след, пригодный для предъявления при проверке.
На этом этапе нужна платформа, в которой реестр активов, оценка критичности, анализ отказов, стратегии обслуживания и планы ТО связаны между собой, а не существуют отдельными файлами у разных специалистов.
Экосистема РАМ-МИР®, разработанная РАМПЕТРОГАЗ, построена по этой логике. Модуль РАМ-RBI(ИУФР) ведёт инспекцию с учётом фактора риска, РАМ-РИСК — HAZOP, LOPA, определение SIL и реестр критичных элементов безопасности, РАМ-ТОиР — стратегии обслуживания и управление работами, РАМ-РАССЛЕДОВАНИЕ — разбор отказов и корректирующие мероприятия с контролем исполнения. Изменение критичности позиции автоматически ставит на пересмотр связанную стратегию и план обслуживания — то, что в табличной модели делается вручную и поэтому не делается вовсе.
Для ОПО существенны два дополнительных свойства: развёртывание в контуре предприятия без передачи данных во внешние сервисы и полный журнал изменений с указанием автора и обоснования каждого решения.
Как обосновать инвестиции в надёжность перед руководством
Технические аргументы редко убеждают финансовый блок сами по себе, нужен язык денег. Внеплановый простой раскладывается на составляющие: недовыпуск продукции за час остановки, разница между стоимостью аварийного и планового ремонта, влияние на смежные установки, штрафные риски по договорам поставки, стоимость внеочередной экспертизы промышленной безопасности.
Когда эти величины сведены в одну таблицу по критичному оборудованию, разговор смещается с «дайте денег на ремонт» к «вот где мы теряем больше всего и вот что это изменит».
Оценка критичности работает здесь как приоритизатор инвестиций. Ограниченная доля позиций формирует основную часть производственного и регуляторного риска: вкладываться в надёжность всего парка одинаково неэффективно, вкладываться адресно — окупаемо. Поэтому реестр и оценка критичности нужны не только инженерам, но и экономистам: без них любые вложения распределяются вслепую.
По опыту проектов РАМПЕТРОГАЗ на объектах нефтегаза, СПГ, нефтепереработки и энергетики типовые диапазоны эффекта таковы: рост технической готовности на 5–15%, сокращение внеплановых простоев на 20–50%, снижение затрат на ТОиР на 10–25%, сокращение избыточных регламентных работ на 15–30%. Фактический результат зависит от исходного состояния объекта и масштаба программы.
Как измерить, что система живёт
Чтобы надёжность не осталась разовой инициативой, вводят ограниченный набор показателей — шесть достаточно:
Показатели пересматриваются регулярно и привязываются к конкретным ответственным. Без владельца показатель превращается в отчётность, а отчётность не меняет практику.
- наработка на отказ (MTBF) по критичным позициям;
- техническая готовность оборудования;
- доля внеплановых работ в общем объёме ТОиР;
- число повторяющихся отказов — прямой индикатор качества расследований;
- исполнение корректирующих мероприятий в установленный срок;
- доля критичного оборудования, охваченного действующими стратегиями обслуживания.
Вывод
Управление надёжностью на ОПО — это система из реестра активов, оценки критичности, анализа отказов, стратегий обслуживания и замыкающего контура показателей, а не набор разрозненных работ. Три условия результата: последовательность уровней, структурированные данные об отказах по ГОСТ Р 70841-2023 (ИСО 14224) и отдельная логика для критичных элементов безопасности. Всё остальное, включая выбор цифровой платформы это производные от этих трёх.
Частые вопросы
С чего дешевле всего начать?
С расследования повторяющихся отказов и оценки критичности оборудования. Оба шага не требуют капитальных вложений и дают материал для последующего анализа. Закупка систем мониторинга на этом этапе преждевременна.
Чем RCM отличается от планово-предупредительного ремонта?
ППР назначает работы по единому календарному графику. RCM назначает их по последствиям и вероятности конкретного вида отказа, поэтому убирает работы, не влияющие на безотказность, и добавляет там, где обязательного объёма недостаточно. Методическая основа в российской практике ГОСТ Р 27.606-2013 «Техническое обслуживание, ориентированное на безотказность», разработанный на базе МЭК 60300-3-11:2009.
Обязательна ли цифровая система для управления надёжностью?
На старте не обязательна. Она становится необходимой примерно с тысячи функциональных позиций, когда вручную невозможно поддерживать связь между критичностью, стратегиями и планами ТО и сохранять аудиторский след решений.
Сколько занимает внедрение на действующем объекте?
Зависит от размера парка оборудования и состояния данных. Обычно работу разбивают на пилот по одной установке и последующее масштабирование: пилот позволяет отладить таксономию отказов и матрицу критичности до того, как они тиражируются на весь объект.